SQL · Guías · 30 de octubre de 2026 · 13 min de lectura
ROW_NUMBER, RANK y DENSE_RANK en SQL: diferencias con empates
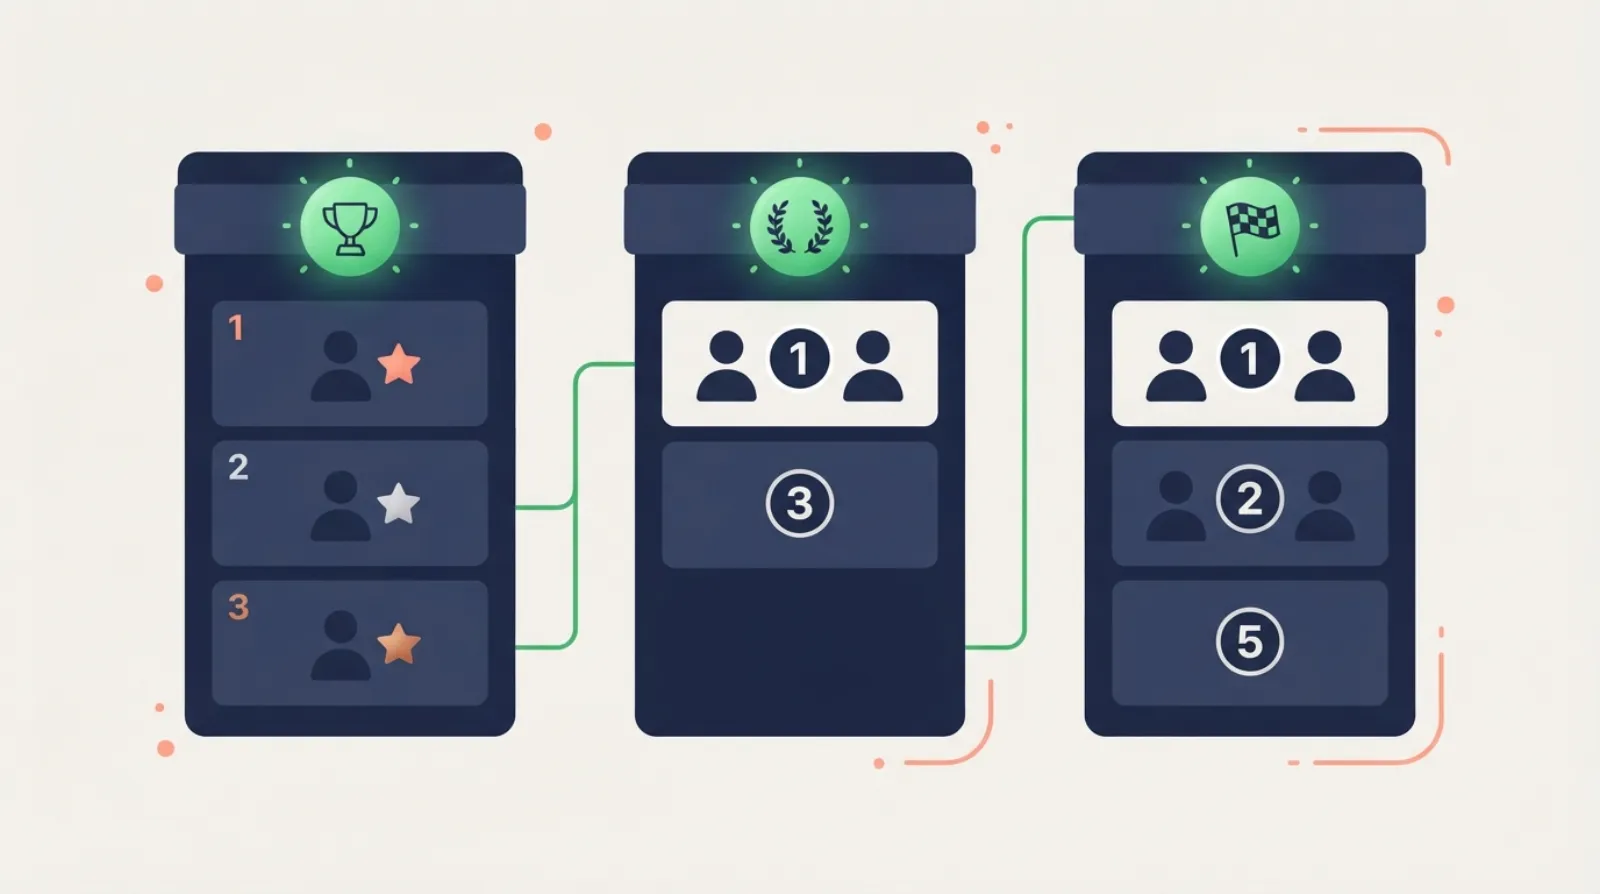
ROW_NUMBER(), RANK() y DENSE_RANK() numeran las filas en el orden que indicas en OVER (ORDER BY ...). Dan el mismo resultado hasta que dos filas empatan. Con un empate, ROW_NUMBER sigue repartiendo números únicos (1, 2, 3, 4), RANK da el mismo número a las filas empatadas y luego salta (1, 2, 2, 4), y DENSE_RANK da el mismo número sin saltar (1, 2, 2, 3). En la práctica: ROW_NUMBER para «exactamente N filas» y para quitar duplicados, RANK para clasificaciones en las que los empatados comparten puesto y DENSE_RANK para «el N-ésimo valor más alto».
Los ejemplos usan la base de datos de una aerolínea del curso de SQL de Nomto, con sintaxis de PostgreSQL sobre DuckDB (el motor de la sala de SQL de Nomto), y cada tabla de resultados es la salida real. Para el panorama completo de OVER, marcos, totales acumulados y LAG, mira la guía de funciones de ventana; esta página trata solo de las funciones de ranking.
La diferencia en una sola tabla
Un ranking de socios del programa de fidelización por número de tramos volados. Varios socios tienen el mismo número, y ahí es justo donde las tres funciones se separan:
WITH m AS (
  SELECT tm.member_id, COUNT(*) AS flights
  FROM ticket_members tm
  JOIN ticket_flights tf ON tf.ticket_no = tm.ticket_no
  GROUP BY tm.member_id
)
SELECT member_id, flights,
       ROW_NUMBER() OVER (ORDER BY flights DESC, member_id) AS row_num,
       RANK()       OVER (ORDER BY flights DESC) AS rnk,
       DENSE_RANK() OVER (ORDER BY flights DESC) AS dense_rnk
FROM m
ORDER BY row_num
LIMIT 11;| member_id | flights | row_num | rnk | dense_rnk |
|---|---|---|---|---|
| 12589 | 33 | 1 | 1 | 1 |
| 2969 | 32 | 2 | 2 | 2 |
| 1659 | 31 | 3 | 3 | 3 |
| 8943 | 31 | 4 | 3 | 3 |
| 37704 | 31 | 5 | 3 | 3 |
| 39173 | 31 | 6 | 3 | 3 |
| 9128 | 30 | 7 | 7 | 4 |
| 15845 | 30 | 8 | 7 | 4 |
| 35285 | 30 | 9 | 7 | 4 |
| 38397 | 30 | 10 | 7 | 4 |
| 6702 | 29 | 11 | 11 | 5 |
Léela fila a fila:
- ROW_NUMBER cuenta de 1 a 11 sin mirar los empates. Los cuatro socios con 31 vuelos reciben 3, 4, 5 y 6 solo por el desempate
member_idde suORDER BY. - RANK da el 3.er puesto a los cuatro y luego salta al 7: los puestos 4, 5 y 6 los «gasta» el empate. Es la posición «cuántas filas tengo delante, más uno».
- DENSE_RANK también les da el 3 y sigue con el 4. Numera valores distintos: 33, 32, 31, 30 y 29 son del 1.º al 5.º número de vuelos distinto.
La misma regla en una frase: RANK cuenta filas, DENSE_RANK cuenta valores distintos, ROW_NUMBER ignora los empates.
Cuántas filas devuelve un «top 5» con cada una
Como tratan los empates de forma distinta, un filtro como <= 5 devuelve un número de filas diferente con cada función:
WITH m AS (
  SELECT tm.member_id, COUNT(*) AS flights
  FROM ticket_members tm
  JOIN ticket_flights tf ON tf.ticket_no = tm.ticket_no
  GROUP BY tm.member_id
), r AS (
  SELECT member_id, flights,
         ROW_NUMBER() OVER (ORDER BY flights DESC, member_id) AS row_num,
         RANK()       OVER (ORDER BY flights DESC) AS rnk,
         DENSE_RANK() OVER (ORDER BY flights DESC) AS dense_rnk
  FROM m
)
SELECT COUNT(*) FILTER (WHERE row_num <= 5)   AS by_row_number,
       COUNT(*) FILTER (WHERE rnk <= 5)       AS by_rank,
       COUNT(*) FILTER (WHERE dense_rnk <= 5) AS by_dense_rank
FROM r;| by_row_number | by_rank | by_dense_rank |
|---|---|---|
| 5 | 6 | 14 |
ROW_NUMBER <= 5devuelve siempre exactamente 5 filas, y deja fuera sin avisar a uno de los cuatro socios empatados con 31.RANK <= 5devuelve 6: todos los que tienen el puesto 5 o mejor, así que entran los cuatro empatados en el 3.er puesto.DENSE_RANK <= 5devuelve 14: todos los que tienen uno de los cinco números de vuelos más altos (33, 32, 31, 30 o 29).
Ninguna está mal; responden a preguntas distintas. Antes de elegir función, aclara cuál es la pregunta.
Top N por grupo con PARTITION BY
Añade PARTITION BY y la numeración vuelve a empezar en cada grupo. Los 3 mejores socios por aeropuerto de origen, para dos aeropuertos, con las tres funciones lado a lado:
WITH m AS (
  SELECT lm.home_airport, tm.member_id, COUNT(*) AS flights
  FROM ticket_members tm
  JOIN ticket_flights tf ON tf.ticket_no = tm.ticket_no
  JOIN loyalty_members lm ON lm.member_id = tm.member_id
  WHERE lm.home_airport IN ('VKO', 'OVB')
  GROUP BY lm.home_airport, tm.member_id
), r AS (
  SELECT home_airport, member_id, flights,
         ROW_NUMBER() OVER (PARTITION BY home_airport ORDER BY flights DESC, member_id) AS rn,
         RANK()       OVER (PARTITION BY home_airport ORDER BY flights DESC) AS rnk,
         DENSE_RANK() OVER (PARTITION BY home_airport ORDER BY flights DESC) AS dense_rnk
  FROM m
)
SELECT * FROM r
WHERE rnk <= 3
ORDER BY home_airport, rn;| home_airport | member_id | flights | rn | rnk | dense_rnk |
|---|---|---|---|---|---|
| OVB | 39502 | 28 | 1 | 1 | 1 |
| OVB | 9835 | 25 | 2 | 2 | 2 |
| OVB | 4544 | 24 | 3 | 3 | 3 |
| OVB | 27427 | 24 | 4 | 3 | 3 |
| OVB | 38226 | 24 | 5 | 3 | 3 |
| OVB | 39050 | 24 | 6 | 3 | 3 |
| VKO | 39173 | 31 | 1 | 1 | 1 |
| VKO | 6702 | 29 | 2 | 2 | 2 |
| VKO | 17160 | 29 | 3 | 2 | 2 |
| VKO | 32434 | 29 | 4 | 2 | 2 |
Filtrar por rnk <= 3 devuelve seis filas para Novosibirsk (cuatro empatados en el 3.er puesto) y cuatro para Vnúkovo (tres empatados en el 2.º). Con rn <= 3 obtendrías exactamente tres por aeropuerto, y cuál de los empatados entra dependería solo del desempate. Para una lista de premiados, eso es injusto; para un widget que «muestra tres ejemplos por aeropuerto», es justo lo que quieres.
Dos reglas valen para cualquier consulta de top N:
- El filtro va fuera.
WHERE rnk <= 3no puede ir en el mismoSELECTque calcularnk, porqueWHEREse ejecuta antes que las funciones de ventana. Calcula el puesto en una CTE o subconsulta y filtra en la consulta exterior. DuckDB, Snowflake, BigQuery y Databricks aceptan además una cláusulaQUALIFY rnk <= 3; PostgreSQL, MySQL y SQL Server no. - Particiona por el grupo, ordena por la métrica.
PARTITION BY home_airport ORDER BY flights DESCsignifica «dentro de cada aeropuerto, por vuelos». Si olvidasPARTITION BY, el ranking es sobre toda la tabla.
Quitar duplicados: una fila por clave con ROW_NUMBER
Para quitar duplicados, los empates son precisamente la cuestión: las filas duplicadas empatan en todo y quieres conservar exactamente una. Es trabajo para ROW_NUMBER, nunca para RANK, que numeraría las dos copias con 1 y conservaría ambas.
La tabla app_events recibe algunos eventos dos veces: mismo cliente, mismo evento, mismo event_time, distinto received_at. Numeramos las copias empezando por la que llegó primero:
SELECT event_id, event_name, event_time, received_at,
       ROW_NUMBER() OVER (PARTITION BY client_id, event_name, event_time
                          ORDER BY received_at, event_id) AS rn
FROM app_events
WHERE client_id = '000034d98b23' AND event_time < '2026-07-05 02:00'
ORDER BY event_time, rn;| event_id | event_name | event_time | received_at | rn |
|---|---|---|---|---|
| 131068 | app_open | 2026-07-05 01:02:07 | 2026-07-05 01:02:07 | 1 |
| 131081 | search | 2026-07-05 01:02:31 | 2026-07-05 01:02:31 | 1 |
| 131116 | search | 2026-07-05 01:02:31 | 2026-07-05 01:03:56 | 2 |
| 131085 | view_offer | 2026-07-05 01:02:41 | 2026-07-05 01:02:42 | 1 |
| 131096 | select_fare | 2026-07-05 01:03:32 | 2026-07-05 01:03:34 | 1 |
El evento search llegó dos veces, con 85 segundos de diferencia; la copia recibe rn = 2. Nos quedamos con rn = 1 en toda la tabla:
WITH ranked AS (
  SELECT ROW_NUMBER() OVER (PARTITION BY client_id, event_name, event_time
                            ORDER BY received_at, event_id) AS rn
  FROM app_events
)
SELECT COUNT(*) AS all_rows,
       COUNT(*) FILTER (WHERE rn = 1) AS kept,
       COUNT(*) FILTER (WHERE rn > 1) AS duplicates
FROM ranked;| all_rows | kept | duplicates |
|---|---|---|
| 1494723 | 1484034 | 10689 |
Las columnas del PARTITION BY definen qué es «la misma fila»; el ORDER BY decide qué copia sobrevive (aquí, la primera recibida; con ORDER BY received_at DESC te quedarías con la última). Añade al final una columna única como event_id para que la elección sea repetible. Otras formas de encontrar y borrar duplicados se comparan en cómo encontrar duplicados en SQL.
El N-ésimo valor más alto: DENSE_RANK
«Encuentra la segunda tarifa más alta» es una pregunta clásica de entrevista, y es donde RANK falla sin hacer ruido. Muchos billetes comparten precio:
WITH p AS (
  SELECT amount,
         RANK()       OVER (ORDER BY amount DESC) AS rnk,
         DENSE_RANK() OVER (ORDER BY amount DESC) AS dense_rnk
  FROM ticket_flights
)
SELECT amount, MIN(rnk) AS rnk, MIN(dense_rnk) AS dense_rnk, COUNT(*) AS tickets
FROM p
WHERE dense_rnk <= 4
GROUP BY amount
ORDER BY amount DESC;| amount | rnk | dense_rnk | tickets |
|---|---|---|---|
| 2033.00 | 1 | 1 | 427 |
| 2013.00 | 428 | 2 | 70 |
| 1998.00 | 498 | 3 | 691 |
| 1993.00 | 1189 | 4 | 856 |
427 billetes cuestan la tarifa máxima de 2.033 $, así que RANK le da al siguiente precio, 2.013 $, el puesto 428. Una consulta con WHERE rnk = 2 devuelve cero filas; WHERE dense_rnk = 2 devuelve 2.013 $, la respuesta correcta. ROW_NUMBER() = 2 devolvería otra vez 2.033 $, porque la segunda fila es simplemente otro billete al precio máximo.
WITH p AS (
  SELECT amount, DENSE_RANK() OVER (ORDER BY amount DESC) AS dense_rnk
  FROM ticket_flights
)
SELECT DISTINCT amount FROM p WHERE dense_rnk = 2;| amount |
|---|
| 2013.00 |
Más preguntas de este estilo en preguntas de entrevista de SQL.
Cuál usar
| Tarea | Función | Por qué |
|---|---|---|
| Exactamente N filas, top N por grupo de tamaño fijo | ROW_NUMBER |
Números únicos; los empates los corta el desempate |
| Quitar duplicados, última fila por clave | ROW_NUMBER |
Las copias empatan y necesitas exactamente una con rn = 1 |
| Paginación con un orden estable | ROW_NUMBER |
Cada fila tiene su propia posición |
| Clasificación, puestos de competición | RANK |
Los empatados comparten puesto y el siguiente se salta (1, 2, 2, 4) |
| Top N incluyendo a todos los empatados en el corte | RANK |
rnk <= N conserva todas las filas empatadas en el puesto N |
| N-ésimo valor más alto o más bajo | DENSE_RANK |
Cuenta valores distintos, sin huecos |
| Top N de valores distintos (los tres precios más altos) | DENSE_RANK |
dense_rnk <= 3 devuelve todas las filas con uno de esos valores |
Una regla más: con ROW_NUMBER, termina siempre el ORDER BY con una columna única. Si el orden tiene empates, la base de datos puede numerar las filas empatadas de otra forma en la siguiente ejecución, y tu «top 5» o tu tabla sin duplicados cambia sin que cambien los datos. RANK y DENSE_RANK no lo necesitan, porque las filas empatadas reciben el mismo número de todos modos.
NTILE, PERCENT_RANK y CUME_DIST
Otras tres funciones de ranking que conviene conocer:
NTILE(n)reparte las filas ordenadas enngrupos de tamaño (casi) igual: cuartiles, deciles.PERCENT_RANK()es(rank - 1) / (filas - 1): 0 para la primera fila, 1 para la última.CUME_DIST()es la proporción de filas con un valor menor o igual que el de la fila actual.
Con los nueve modelos de avión, ordenados por autonomía:
SELECT model, range,
       NTILE(4) OVER (ORDER BY range DESC) AS quartile,
       ROUND(PERCENT_RANK() OVER (ORDER BY range), 3) AS pct_rank,
       ROUND(CUME_DIST() OVER (ORDER BY range), 3) AS cume_dist
FROM aircrafts
ORDER BY range DESC;| model | range | quartile | pct_rank | cume_dist |
|---|---|---|---|---|
| Boeing 777-300 | 11100 | 1 | 1 | 1 |
| Boeing 767-300 | 7900 | 1 | 0.875 | 0.889 |
| Airbus A319-100 | 6700 | 1 | 0.75 | 0.778 |
| Airbus A320-200 | 5700 | 2 | 0.625 | 0.667 |
| Airbus A321-200 | 5600 | 2 | 0.5 | 0.556 |
| Boeing 737-300 | 4200 | 3 | 0.375 | 0.444 |
| Sukhoi Superjet-100 | 3000 | 3 | 0.25 | 0.333 |
| Bombardier CRJ-200 | 2700 | 4 | 0.125 | 0.222 |
| Cessna 208 Caravan | 1200 | 4 | 0 | 0.111 |
Nueve filas no se reparten en cuatro grupos iguales, así que el primero se lleva la fila de más (3, 2, 2, 2).
NTILE tiene el mismo punto ciego que ROW_NUMBER: ignora los empates. Repartimos todos los socios en deciles por vuelos:
WITH m AS (
  SELECT tm.member_id, COUNT(*) AS flights
  FROM ticket_members tm
  JOIN ticket_flights tf ON tf.ticket_no = tm.ticket_no
  GROUP BY tm.member_id
), t AS (
  SELECT member_id, flights,
         NTILE(10) OVER (ORDER BY flights DESC, member_id) AS decile
  FROM m
)
SELECT decile, COUNT(*) AS members, MIN(flights) AS min_flights, MAX(flights) AS max_flights
FROM t
GROUP BY decile
ORDER BY decile;| decile | members | min_flights | max_flights |
|---|---|---|---|
| 1 | 4158 | 8 | 33 |
| 2 | 4158 | 6 | 8 |
| 3 | 4158 | 6 | 6 |
| 4 | 4158 | 4 | 6 |
| 5 | 4157 | 4 | 4 |
| 6 | 4157 | 4 | 4 |
| 7 | 4157 | 3 | 4 |
| 8 | 4157 | 2 | 3 |
| 9 | 4157 | 2 | 2 |
| 10 | 4157 | 1 | 2 |
Los grupos tienen el mismo tamaño, pero los socios con 8 vuelos caen tanto en el decil 1 como en el 2, y los de 4 vuelos se reparten entre cuatro deciles. Si el «10 % superior» no debe partir valores iguales, usa PERCENT_RANK() <= 0.1 o CUME_DIST(), que dan el mismo valor a las filas empatadas.
Notas por motor
ROW_NUMBER, RANK, DENSE_RANK, NTILE, PERCENT_RANK y CUME_DIST son SQL estándar y funcionan igual en PostgreSQL, DuckDB, SQL Server (las dos últimas desde 2012), Oracle, BigQuery y Snowflake. MySQL las tiene desde la versión 8.0; MySQL 5.7, todavía frecuente en hostings compartidos y aplicaciones antiguas, no tiene funciones de ventana. SQL Server exige ORDER BY dentro de OVER en todas ellas, incluida ROW_NUMBER; PostgreSQL y DuckDB aceptan ROW_NUMBER() OVER (), pero entonces la numeración es arbitraria. Si trabajas con Power BI, la misma lógica existe en DAX con RANKX (con opción Skip o Dense para los empates).
Preguntas frecuentes
¿Qué diferencia hay entre ROW_NUMBER, RANK y DENSE_RANK?
Solo se diferencian en los empates. ROW_NUMBER da a cada fila un número único (1, 2, 3, 4). RANK da el mismo número a las filas empatadas y se salta los siguientes (1, 2, 2, 4). DENSE_RANK da el mismo número a las empatadas sin saltar (1, 2, 2, 3).
¿Cuál uso para el top N por grupo?
ROW_NUMBER si cada grupo debe devolver exactamente N filas. RANK si deben entrar todos los empatados en el puesto N, lo que puede devolver más de N filas por grupo. En ambos casos, calcula el número en una CTE y filtra en la consulta exterior.
¿Por qué RANK se salta números?
Porque RANK es el número de filas que hay delante de la actual, más uno. Si cuatro filas empatan en el 3.er puesto, la siguiente tiene seis filas delante, así que es la 7.ª. DENSE_RANK cuenta valores distintos, así que la siguiente es la 4.ª.
¿Cómo obtengo el segundo valor más alto en SQL?
Usa DENSE_RANK() OVER (ORDER BY valor DESC) y quédate con dense_rnk = 2. RANK puede no devolver nada si el valor máximo lo comparten varias filas, y ROW_NUMBER puede devolver otra vez el valor máximo.
¿ROW_NUMBER es determinista?
Solo si el ORDER BY dentro de OVER es único. Con empates en el orden, la base de datos puede numerar las filas empatadas de forma distinta entre ejecuciones. Añade una columna única, como un id, como último criterio de orden.
También en English, Português (Brasil), Tiếng Việt, 简体中文